01
Ввод данных
Проверяем формат и качество исходных последовательностей.
Ускоряем разработку лекарств, используя
компьютерное построение
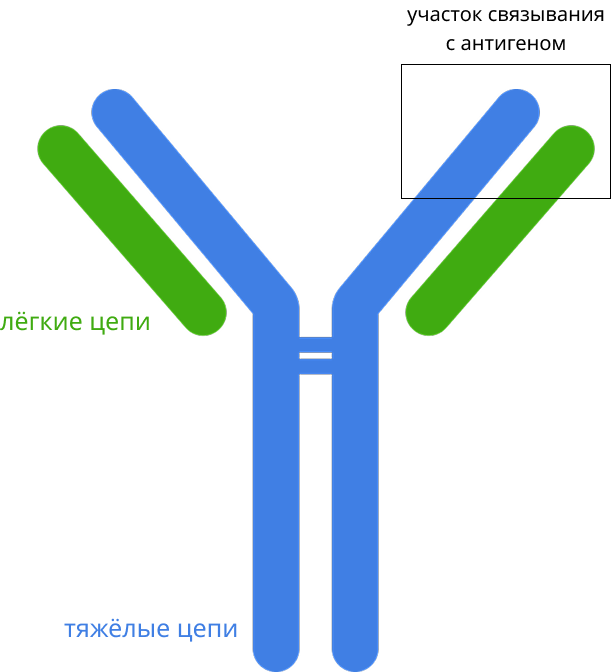
Защитный белок, который можно представить как «липучку». Антитело узнаёт конкретную молекулу-мишень в организме, прикрепляется к ней и либо блокирует её работу, либо помогает иммунной системе заметить опасную клетку или вирус.
Но проблема в том, что вариантов антител может быть очень много. Даже небольшая мутация, то есть замена одной «буквы» в последовательности, может изменить свойства антитела.
Иммуноглобулин G (IgG) — Y-образный белок из четырёх цепей: двух тяжёлых (H) и двух лёгких (L), сшитых дисульфидными связями. Две верхние цепи узнают мишень, нижняя цепь подаёт сигнал иммунным клеткам — уничтожить помеченный объект.
Мишень называется антигеном: это фрагмент вируса, бактерии или изменённой клетки. Антитело связывает не весь антиген целиком, а маленький участок его поверхности — эпитоп.
Каждая цепь собрана из доменов. На концах цепей лежат вариабельные домены (VH и VL) — именно они различаются у разных антител. Остальные домены константные и почти одинаковы у всех молекул одного класса.
Внутри вариабельного домена чередуются четыре каркасных участки (FR1–FR4) и три гипервариабельные петли (CDR1–CDR3). Каркас держит форму, а петли CDR физически касаются антигена и решают, к чему антитело прилипнет. Границы петель размечают консервативные якоря — цистеин и триптофан; по ним нумерация IMGT находит CDR3, самый разнообразный участок молекулы.
Поэтому замена в CDR меняет связывание намного сильнее, чем такая же замена в каркасе, — и пайплайн в первую очередь смотрит именно на эти позиции.
Антитела — идеальное оружие против болезней. В отличие от химических препаратов, они действуют точечно: распознают только нужную мишень и не трогают здоровые клетки.
Но создать работающее антитело непросто. Его эффективность зависит от множества аминокислотных замен, и каждая комбинация даёт непредсказуемый результат. Вариантов — бесчисленное множество, синтезировать их все невозможно.
Наш подход основан на построении филогенетических деревьев для групп антител, близких по структуре. Анализируя ветвления и накопленные замены, мы отслеживаем, какие мутации возникали и закреплялись в ходе естественной эволюции. Это позволяет выделить позиции, где изменения с высокой вероятностью вели к улучшению целевых характеристик — и именно их мы рассматриваем как приоритетные для дальнейшей инженерии.
Филогенетическое дерево — схема родства последовательностей. Листья на концах ветвей — реальные антитела из образца, внутренние узлы — их предполагаемые общие предки, а корень дерева — зародышевая (germline) последовательность, с которой всё началось.
Длина ветви показывает, сколько замен накопилось на этом участке пути. Клада — узел вместе со всеми потомками, то есть группа антител, происходящих от одного общего предка.
Ветви неравноценны: у каждой есть оценка надёжности. IQ-TREE считает бутстреп-поддержку (UFBoot), MrBayes — апостериорную вероятность. Мы считаем кладу уверенной, когда UFBoot не ниже 95 и aLRT не ниже 80, а байесовская модель даёт вероятность от 0,95.
Дальше дерево читается так: если замена возникла на ветви, ведущей к уверенной кладе, и сохранилась у всех её потомков — скорее всего, её закрепил отбор, а не случайность. Такие позиции и становятся кандидатами.
Цель: реализация программного пайплайна на основе филогенетического анализа, который будет по последовательностям антител определять позиции потенциально важных мутаций и формировать рекомендации кандидатов для дальнейшей разработки лекарства.
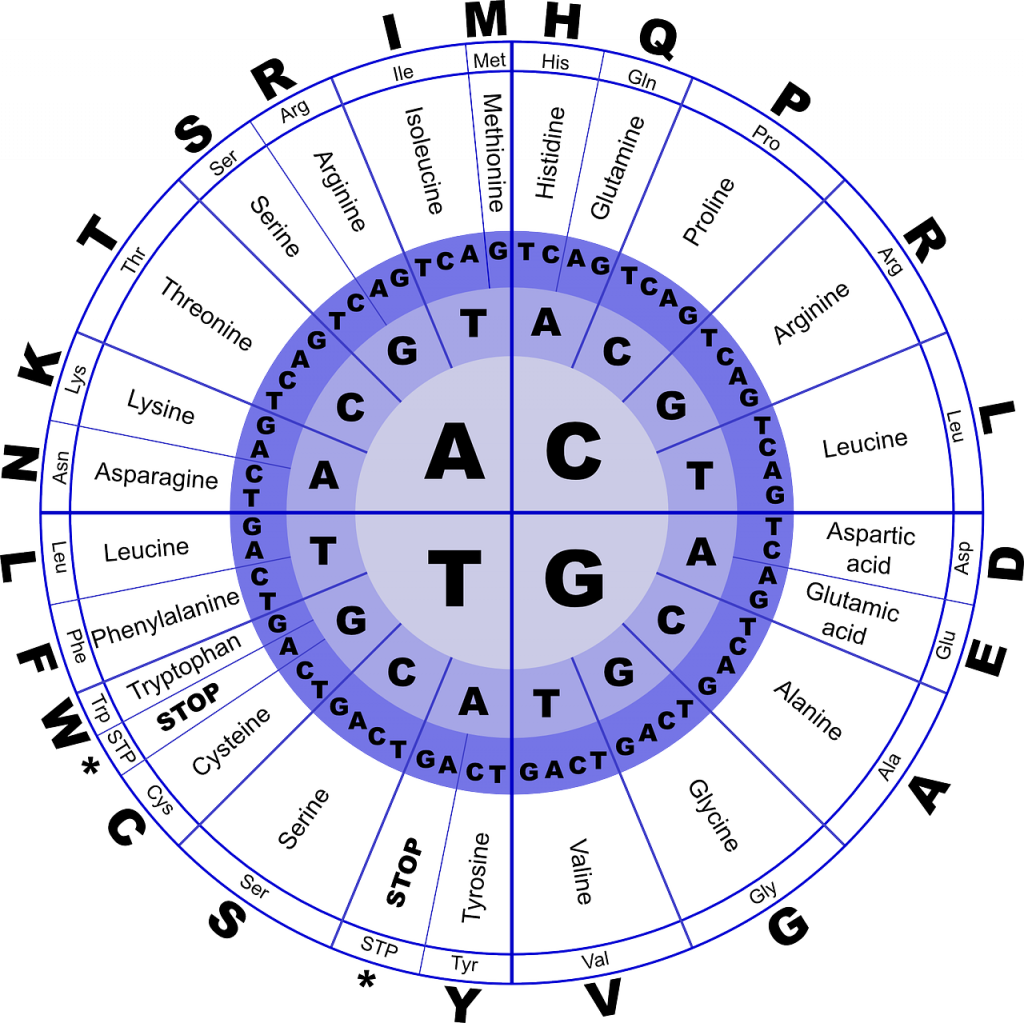
Кодон — три буквы ДНК, задающие аминокислоту. Измените любую букву и посмотрите, как замена отражается на белке.
Сначала очищаем данные, затем объединяем родственные последовательности, выравниваем их и строим деревья, чтобы найти значимые мутации.
Проверяем формат и качество исходных последовательностей.
Объединяем родственные последовательности по V / (D) / J-генам.
Сопоставляем позиции и сохраняем рамку считывания.
Строим две независимые модели: IQ-TREE и MrBayes.
Сопоставляем ветви и формируем список приоритетных замен.
Подробно по этапам
Лаборатория считывает генные последовательности антител. Мы проверяем формат, удаляем неполные записи и сохраняем только продуктивные цепи.
>seq_001 | heavy_chain
ATGCAGGTGCAGCTG...
>seq_002 | light_chain
GATATTGTGATGACC...
Последовательности распределяются по гермлайновым генам V / (D) / J, а близкие варианты собираются в отдельные клональные семьи.
Сравниваем ДНК-последовательности буква к букве, чтобы увидеть совпадения и мутации. Для сравнения используем классический режим и режим с учётом рамки считывания.
Рамка считывания — разбиение последовательности ДНК на кодоны, тройки нуклеотидов. Каждая тройка кодирует одну аминокислоту, и клетка читает ген строго по три буквы, начиная от старт-кодона.
При выравнивании программа вставляет пропуски, чтобы совместить похожие участки. Если пропуск не кратен трём, все последующие кодоны сдвигаются — происходит сдвиг рамки. После него белок читается неверно: аминокислоты получаются чужие, а часто возникает и преждевременный стоп-кодон.
MAFFT выравнивает нуклеотиды как обычный текст и о кодонах не знает, поэтому может разрезать тройку пополам. MACSE выравнивает с учётом рамки: держит кодоны целыми и добавляет пропуски порциями по три.
Это не косметика. Только при сохранённой рамке замену можно честно назвать синонимичной (аминокислота не изменилась) или значимой (изменилась) — а весь дальнейший отбор кандидатов держится именно на этом различии.
germlineA C G T A G C T clone_01A C G C A G C T clone_02A C G — A G C T clone_03A C G T A G G T germlineATG CAG GTG CAG clone_01ATG CAA GTG CAG clone_02ATG --- GTG CAG clone_03ATG CAG GTA CAG IQ-TREE и MrBayes строят независимые модели. Совпавшие ветви с высокой поддержкой становятся наиболее надёжными кандидатами для анализа мутаций.
IQ-TREE ищет дерево, лучше всего объясняющее данные. MrBayes оценивает вероятности деревьев. Совпавшие выводы надёжнее.
Простым языком: мы видим сегодняшние последовательности, но не знаем путь их эволюции. IQ-TREE сравнивает варианты дерева и выбирает тот, при котором увиденные данные наиболее вероятны.
Простым языком: это обратная задача. MrBayes рассматривает множество возможных деревьев и оценивает вероятность каждого после того, как увидел данные.
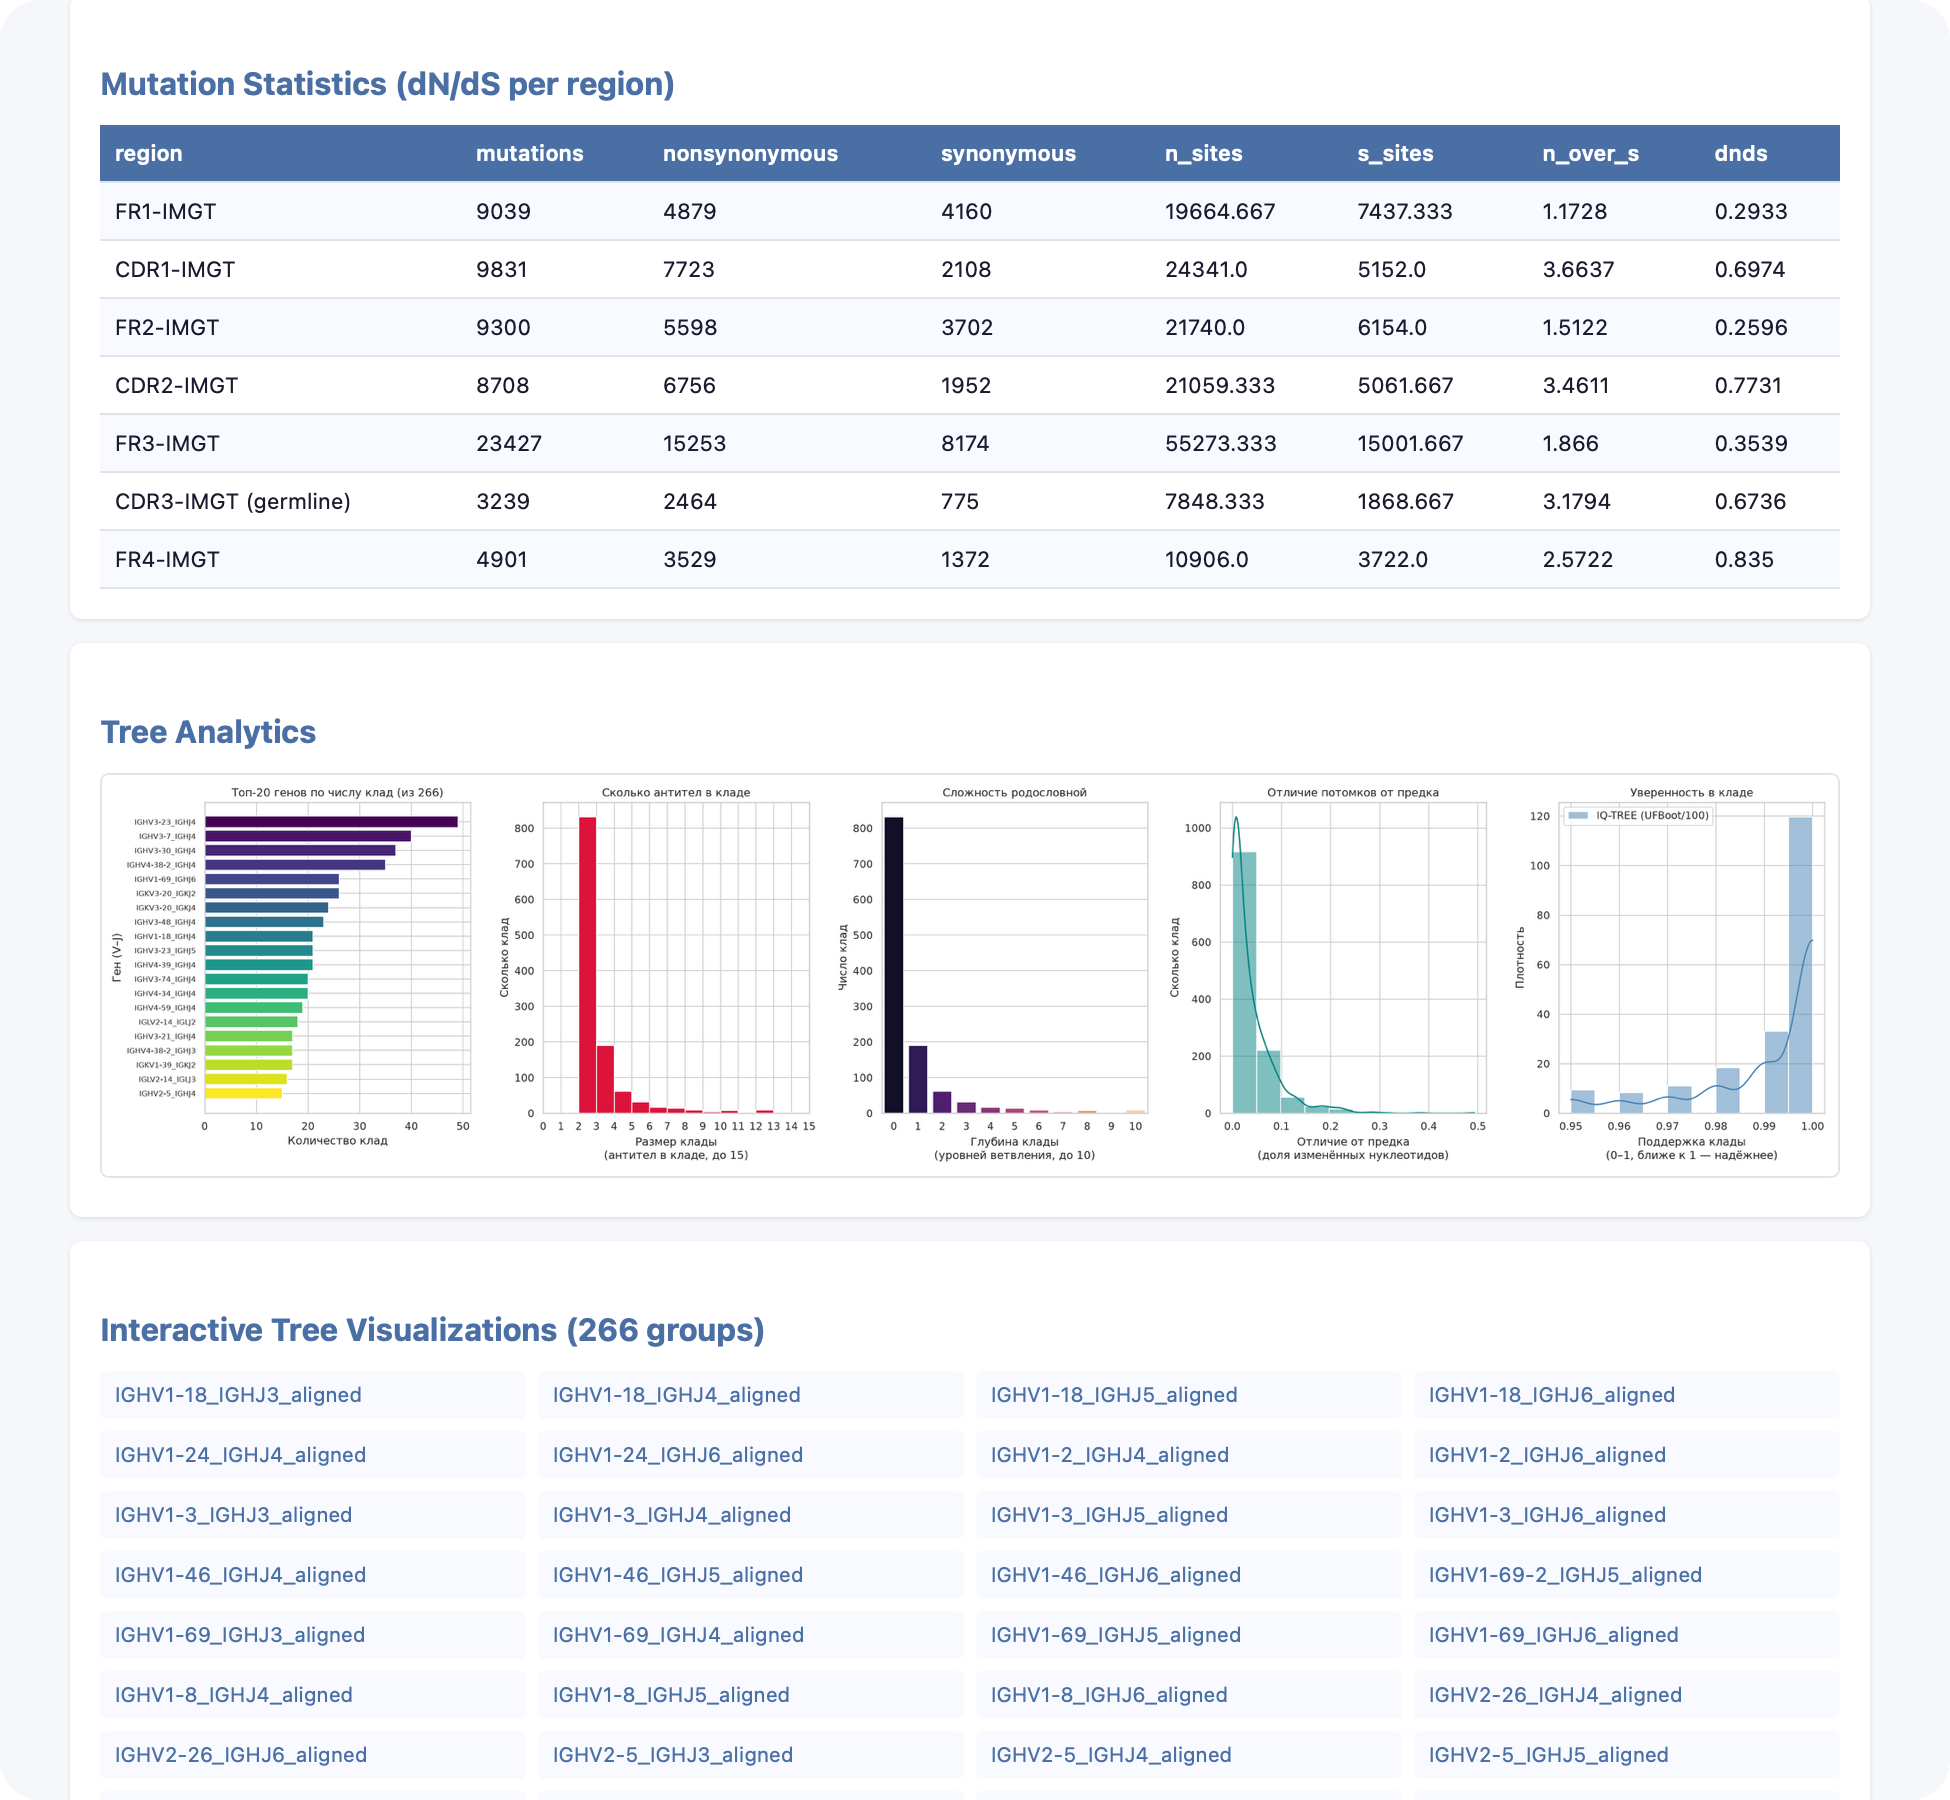
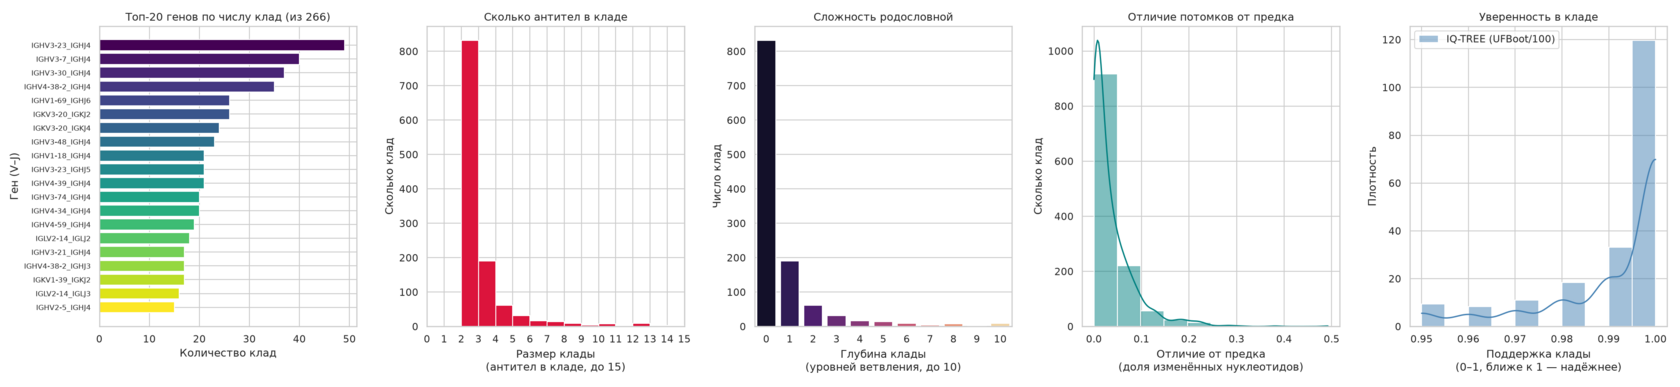
Графики показывают распределение генов, размеров и глубины клад и накопление замен. Таблица ниже связывает каждую мутацию с позицией IMGT, исходным кодоном и новой аминокислотой.
| sequence_id | region | imgt_pos | ref_aa | mut_aa | ref_codon | mut_codon |
|---|---|---|---|---|---|---|
| ATAGACCAGGGCATGT-1_contig_2 | FR1 | 11 | V | L | GTG | TTG |
| ATAGACCAGGGCATGT-1_contig_2 | FR1 | 23 | K | Q | AAG | CAG |
| ATAGACCAGGGCATGT-1_contig_2 | CDR1 | 30 | F | L | TTC | CTC |
| ATAGACCAGGGCATGT-1_contig_2 | CDR1 | 31 | S | N | AGC | AAC |
Инструменты, принятые в филогенетике и биоинформатике.
Множественное выравнивание последовательностей.
Деревья максимального правдоподобия и bootstrap.
Байесовский подход к оценке надёжности клад.
Аннотация V(D)J и поиск гермлайновых генов.
Выравнивание с учётом рамки считывания.
Подготовка, обработка и анализ последовательностей.
Графический интерфейс открывает каталог прогона и показывает результат по каждой клональной группе: дерево, выравнивание с разметкой FR и CDR, таблицу мутаций и список достоверных клад.
Шесть вопросов, которые чаще всего возникают к нашему решению.
Порядка десяти миллиардов различных вариантов. Иммунная система собирает их случайными комбинациями V-, D- и J-генов, а затем дорабатывает точечными заменами — этот процесс называется соматическим гипермутированием. Именно поэтому иммунная защита у каждого человека своя.
Типичное антитело — это две тяжёлые цепи примерно по 450 аминокислот и две лёгкие примерно по 220, всего около 1340 позиций. Каждая из них — потенциальная точка замены, а замены ещё и сочетаются между собой. Синтезировать и проверить такой объём в лаборатории невозможно, поэтому перебор нужно сузить заранее.
Иммунная система уже провела этот перебор за нас: при созревании аффинности отбор сохранял те клетки, чьи антитела связывали мишень прочнее. Мы читаем результат уже состоявшегося эксперимента — какие замены закрепились и передались потомкам, — вместо того чтобы генерировать варианты вслепую.
IQ-TREE и MrBayes опираются на разную математику: первый ищет дерево с наибольшим правдоподобием, второй оценивает вероятности целого множества деревьев. Ветвь, которую подтверждают оба, — это как два независимых свидетеля, описавших одно и то же событие. Совпадение и служит нам критерием доверия.
Генетический код избыточен: разные тройки нуклеотидов кодируют одну и ту же аминокислоту. Например, GGT и GGC — обе глицин. Такая замена меняет ДНК, но не меняет белок, поэтому на свойства антитела не влияет и в кандидаты не идёт. Проверить это можно прямо в интерактиве выше.
Когда её независимо подтверждают обе оценки надёжности: бутстреп-поддержка не ниже 95 и SH-aLRT не ниже 80, а для байесовского пути — апостериорная вероятность от 0,95. На нашем прогоне из 357 клональных групп такой порог прошли 742 клады — именно их замены и попадают в список кандидатов.
Биоинформатик · деревья IQ-TREE, визуализация, таблицы мутаций
Биоинформатик · обработка исходных данных и клональная группировка
Биоинформатик · множественное выравнивание последовательностей
Биоинформатик · байесовский анализ и отбор достоверных клад
Аналитик отдела разработки биоинформатического программного обеспечения, BIOCAD
Руководитель отдела разработки биоинформатического программного обеспечения, BIOCAD